


随着服务时长增长,优质AI客服系统往往展现出越来越精准的应答能力。这种"越用越聪明"的特性背后,是一套复杂的自主学习体系在持续运转。
一、数据闭环的构建
1.1 交互数据的实时采集
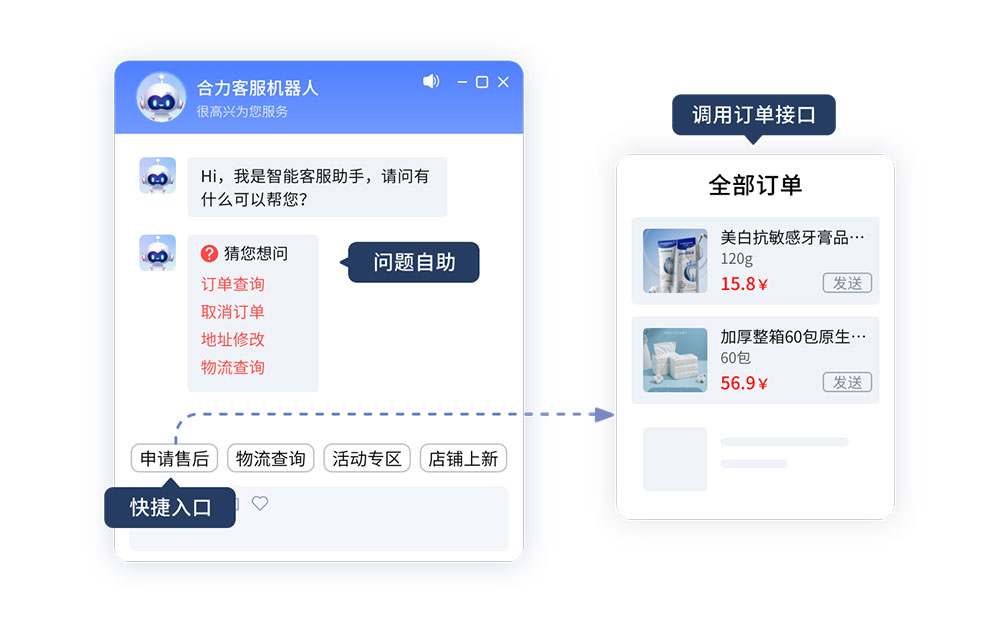
系统自动记录每次对话的完整文本、用户反馈和解决结果,形成结构化案例库。特别标注转人工的对话节点,分析AI的应对短板。
1.2 多维特征的智能标注
通过自然语言处理技术,为每条对话打上问题类型、情绪状态、解决难度等标签,构建可检索的案例网络,便于后续模型训练。
1.3 数据清洗的严格流程
建立噪声过滤机制,剔除无效对话和敏感信息,确保训练数据质量。专家团队定期审核数据标注准确性,保障学习基础可靠。
二、算法模型的进化
2.1 增量学习的持续优化
采用在线学习技术,新数据不断微调模型参数,避免传统批量训练导致的"灾难性遗忘"。模型每周自动更新,保持对新问题的适应力。
2.2 多任务学习的协同训练
同步优化意图识别、实体抽取、情感分析等子任务,各模块间共享底层特征表示,提升整体理解能力,减少语义偏差。
2.3 强化学习的反馈利用
将用户满意度评分、问题解决率等业务指标转化为奖励信号,引导模型向高满意度应答策略演进,形成正向循环。
三、知识体系的更新
3.1 动态知识图谱扩展
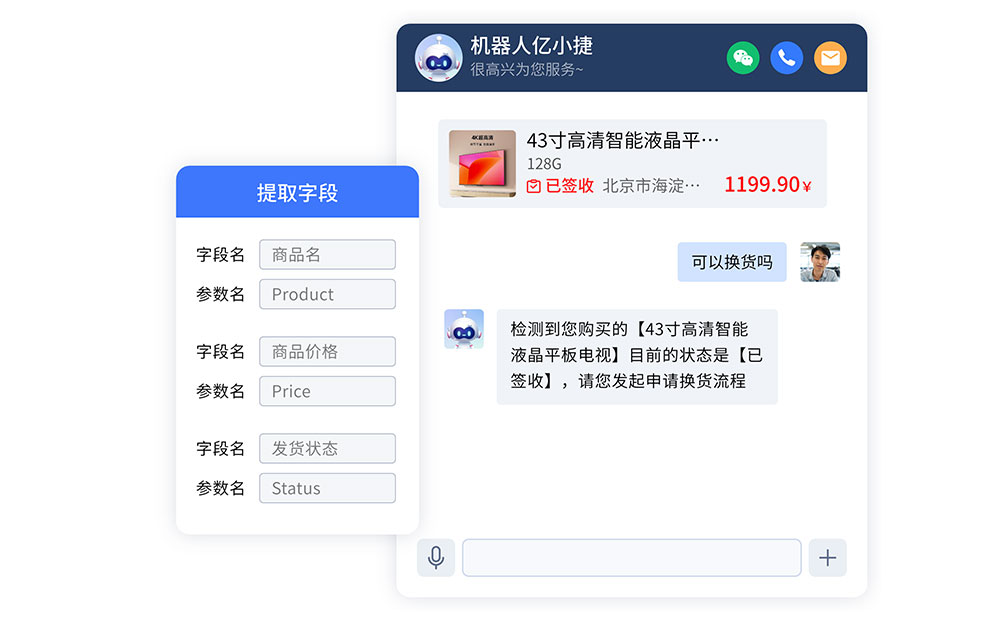
新业务术语和产品信息自动抽取入库,通过实体链接技术与现有知识关联,持续丰富系统的专业知识储备。
3.2 热点问题的快速响应
监测咨询话题的突发变化,如政策调整或产品更新,专家团队48小时内完成相关知识审核入库,确保应答时效性。
3.3 边缘案例的专项学习
对高频转人工的问题类型进行聚类分析,针对性补充训练数据和知识条目,逐步填补服务盲区。
四、学习效果的验证
4.1 A/B测试的严谨实施
保留旧模型作为对照组,新模型在小流量环境测试,比较关键指标变化,验证学习效果后再全量上线。
4.2 业务指标的量化追踪
建立意图识别准确率、问题解决率、客户满意度等核心指标看板,量化评估每次迭代的业务价值。
4.3 人工审核的补充校验
专家团队定期抽样检查复杂案例的处理质量,防止算法优化偏离实际业务需求,确保学习方向正确。
五、技术实现的保障
5.1 分布式计算架构
采用弹性计算资源,支持大规模训练任务快速执行,保障模型更新频率,避免数据积压导致的滞后学习。
5.2 版本控制的严格管理
每次模型更新保留完整版本记录和回滚路径,一旦新版本表现异常可快速恢复,保障服务稳定性。
5.3 安全边界的清晰设定
建立学习内容过滤机制,防止模型从不良对话中习得不当回应。伦理审查确保AI行为符合企业价值观。
结语:持续进化的服务智能
AI客服的自主学习能力不是魔法般的自动进步,而是数据、算法、知识协同作用的系统工程。当企业能够构建完整的学习闭环,当技术迭代始终服务于业务目标,这样的智能客服才能实现"越用越聪明"。