


当用户询问“如何修改订单地址”时,传统客服机器人可能因缺乏上下文而机械应答,而经过充分训练的系统却能结合用户历史订单状态、物流节点等信息,提供“您的包裹已进入分拣中心,修改地址需支付差价并联系人工客服”的精准指导。这种能力差异背后,是数据收集与整理的质量差距。本文将系统拆解机器人客服对话训练所需的数据类型,并揭示提升数据可用性的关键技巧。

一、核心数据类型:构建对话能力的三大支柱
1. 用户交互数据:对话行为的“原始记录”
用户交互数据是训练模型理解自然语言的核心素材,包含三类信息:
文本对话日志:记录用户提问与系统应答的完整序列,例如用户询问“退货流程”后,系统分步说明“登录账户-进入订单详情-申请售后”的对话轨迹。这类数据需保留时间戳、对话轮次等元信息,以支持上下文建模。
多轮对话轨迹:在复杂场景中(如技术故障排查),用户可能通过多轮交互逐步明确需求。系统需记录每次提问的意图分类(如“确认问题”“补充信息”),帮助模型学习对话状态转移规律。
用户反馈信号:显式反馈(如点击“有帮助”按钮)与隐式反馈(如对话中断前的问题重复次数)共同构成训练信号。例如,若用户连续三次询问同一问题未获解决,可标记该对话为“低质量交互”,指导模型优化应答策略。
2. 领域知识库:专业能力的“知识源泉”
领域知识库为机器人提供结构化的业务规则,主要包含:
业务规则文档:涵盖退货政策、服务条款等静态知识,例如“电子产品7天无理由退货需保持商品完好”的规则描述。这类数据需通过知识图谱构建实体关系(如“商品-退货条件-时间限制”),支持模型快速检索。
FAQ集合:高频问题与标准答案的配对库,例如“如何开通会员?”对应“登录账户-进入个人中心-选择会员套餐-完成支付”的分步指引。FAQ需定期更新以覆盖新业务场景。
操作流程指南:针对复杂任务(如账户注销)的步骤化说明,需拆解为原子操作(如“验证身份”“清空余额”)并标注前置条件,帮助模型生成可执行的引导话术。
3. 多模态数据:交互体验的“扩展维度”
随着语音、图像交互的普及,多模态数据成为提升服务体验的关键:
语音数据:包含声纹特征、语速、音调等非文本信息。例如,用户语速加快且音调升高时,可能暗示焦虑情绪,系统需调整应答语气或优先转接人工。
图像数据:用户上传的商品照片、截图等视觉信息。当用户询问“这款鞋有42码吗?”时,系统通过图像识别提取商品型号,结合库存数据给出准确答复。
环境上下文:结合用户设备类型(如手机/PC)、地理位置(如判断是否为偏远地区)等外部信息,动态调整服务策略。例如,向移动端用户推送简化版操作指引。
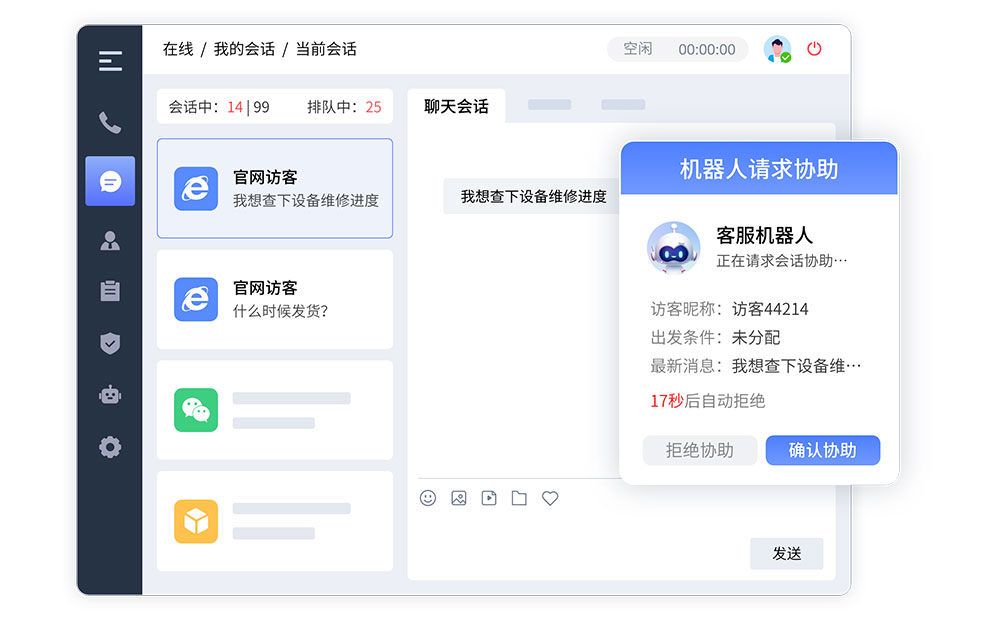
二、数据收集技巧:从“量”到“质”的跨越
1. 日志采集的全面性与合规性
系统需记录用户与机器人的完整交互链路,包括输入文本、系统应答、用户后续行为(如点击链接、结束对话)等。采集过程中需严格遵循隐私保护原则,对身份证号、联系方式等敏感信息进行脱敏处理,例如将手机号替换为“”掩码。
2. 主动采集与被动收集的结合
除记录自然发生的对话外,可通过以下方式扩充数据:
用户调研:设计结构化问卷收集用户对服务体验的评价,例如“您认为当前应答是否清晰?”的选项反馈。
模拟对话:由人工标注员模拟用户提问,覆盖长尾业务场景(如极端情况下的政策解读),弥补真实数据分布不均的问题。
A/B测试:对比不同应答策略的用户反馈,例如测试“简洁版”与“详细版”退货指引的接受度,筛选更优方案。
三、数据整理技巧:提升数据可用性的关键步骤
1. 数据清洗的标准化流程
原始数据常包含噪声(如重复对话、乱码输入),需通过以下步骤净化:
去重处理:删除完全相同的对话记录,避免模型训练时重复学习。
异常值过滤:剔除对话轮次过长(如超过20轮)或过短(如单轮结束)的极端案例,聚焦典型场景。
语言规范化:统一文本格式(如全角/半角符号转换)、纠正拼写错误,减少模型学习干扰。
2. 数据标注的规范性与一致性
标注是赋予数据语义的关键环节,需遵循:
意图分类体系:定义清晰的意图标签(如“查询物流”“投诉建议”),确保不同标注员对同类问题的归类一致。
槽位填充规则:针对需要提取关键信息的场景(如“修改地址为XX路XX号”),制定槽位(如“目标地址”)的标注规范,避免信息遗漏。
多轮对话标注:标记对话中的状态转移(如从“确认问题”到“提供解决方案”),帮助模型理解对话逻辑。
3. 数据增强的多样性扩展
为提升模型泛化能力,可通过以下方式扩充数据:
同义词替换:将“退货”替换为“退单”“申请退款”等近义词,增强模型对词汇变体的理解。
句式变换:改写用户提问的句式(如将“怎么改地址?”变为“地址修改流程是什么?”),模拟不同表达习惯。
噪声注入:在文本中随机插入拼写错误或无关词汇,提升模型对干扰信息的鲁棒性。
四、数据管理的长期挑战与应对
1. 数据版本控制与回溯
随着业务规则更新(如退货政策调整),需同步维护知识库与对话数据的版本。通过版本号标记数据来源,确保模型训练时使用一致的知识集,避免因数据冲突导致应答矛盾。
2. 隐私保护与合规性
在数据存储与传输过程中,采用加密技术(如AES加密)保护用户信息。定期审计数据访问权限,防止非授权人员获取敏感数据。
3. 动态更新机制
建立数据监控体系,实时跟踪模型应答质量指标(如用户满意度、问题解决率)。当指标下降时,触发数据回溯流程,定位低质量数据来源并补充采集。
结语:数据质量决定客服智能化的天花板
机器人客服的对话能力并非由算法复杂度单独决定,而是高度依赖于数据的质量与多样性。从用户交互的原始记录到领域知识的结构化整理,从多模态信息的融合到数据标注的精细化,每一个环节都影响着模型的理解与生成能力。未来,随着隐私计算技术的发展,如何在保护用户隐私的前提下实现数据的高效利用,将成为客服智能化领域的重要课题。对于企业而言,构建完善的数据收集与整理体系,不仅是技术投入,更是对用户体验的长期承诺。